 ⬅ Volver a Recursos
En este primer caso práctico de análisis de datos reales con Python, exploramos la evolución de la edad mediana en Colombia y el mundo a lo largo del tiempo. A través de un ejercicio visual y sencillo, mostramos cómo interpretar datos poblacionales actuales y qué revelan sobre tendencias como el envejecimiento global. Una guía perfecta para aprender a convertir datasets en historias que conectan.
Hoy te traigo un tutorial corto para que pongas en práctica tus conocimientos en Python, aprendiendo a realizar análisis exploratorios con datos reales. En este caso, trabajaremos con información extraída de Our World in Data, una de las fuentes más reconocidas para el análisis de tendencias demográficas. El objetivo es analizar cómo ha evolucionado la edad mediana tanto en Colombia como a nivel mundial, comparando su comportamiento en la actualidad con periodos históricos. Este ejercicio no solo te permitirá fortalecer tus habilidades técnicas en Python, sino también entender mejor los cambios poblacionales que estamos viviendo.
Para este ejercicio utilizaremos Google Colab, una herramienta gratuita que permite programar en Python directamente desde el navegador, sin necesidad de instalar nada en el computador. Si aún no tienes una cuenta de Google, puedes crearla fácilmente en pocos minutos. Luego, accede a tu cuenta de Google Colab en el siguiente enlace: https://colab.google/.
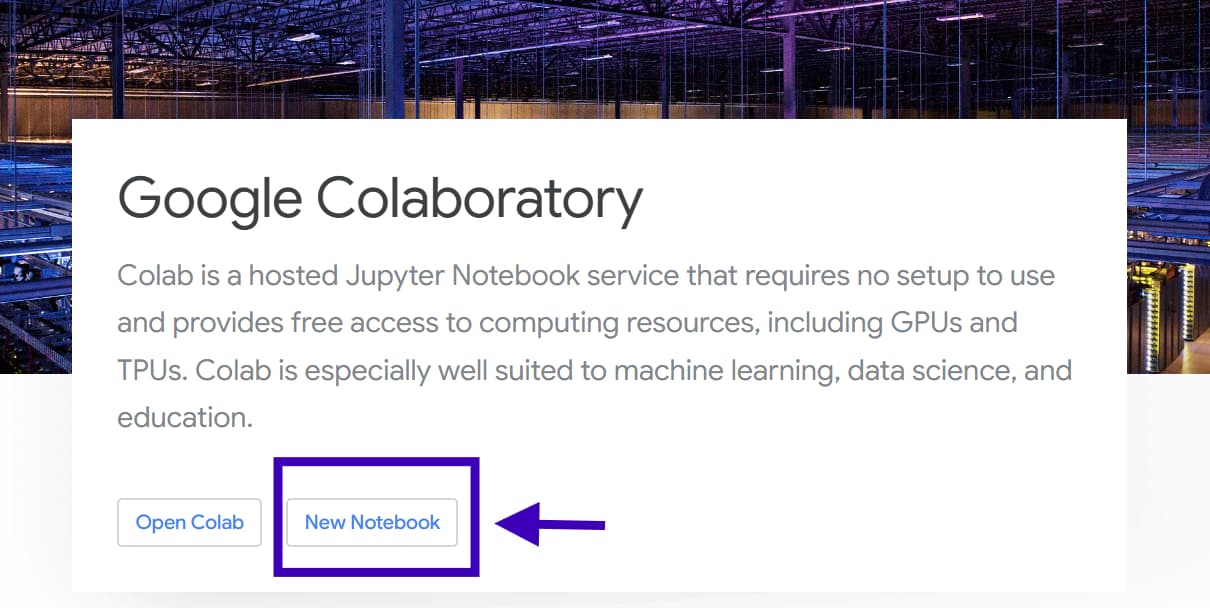
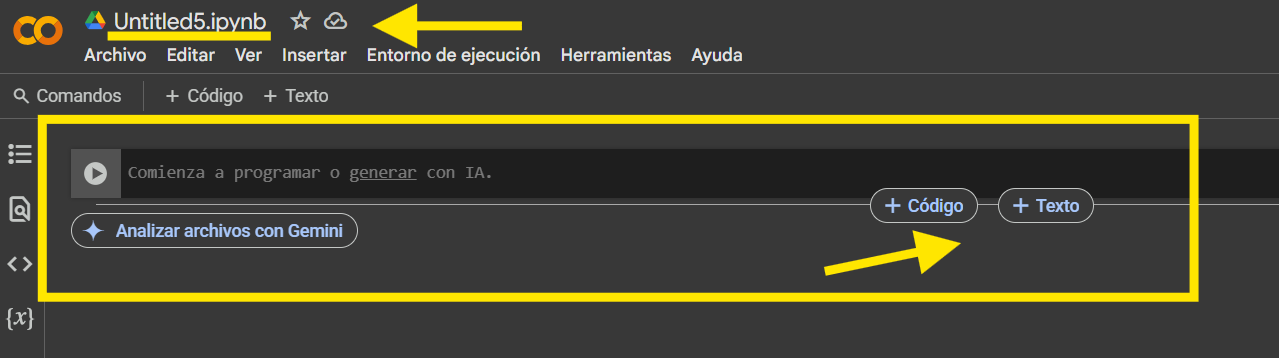
Una vez ingreses a tu nuevo notebook, te recomiendo asignarle un nombre claro, por ejemplo: Edad Mediana - Exploratorio. Dentro del notebook encontrarás dos tipos de celdas: celdas de texto y celdas de código. Puedes escribir texto normalmente, como lo harías en un procesador de texto. Además, si deseas estructurar mejor tus apuntes o explicaciones, puedes utilizar etiquetas de encabezado:
Todo lo que vas a realizar a continuación está disponible en el siguiente repositorio de GitHub: Ver notebook en GitHub. Sin embargo, en este tutorial te guiaré paso a paso, explicándote en detalle qué hace cada bloque de código para que comprendas claramente el proceso hasta llegar al resultado final.
Para comenzar el análisis y la identificación de insights en el conjunto de datos, lo primero que haremos es importar las librerías necesarias para cargar el dataset de Our World in Data.
En el código que te mostraré a continuación, se incluye la opción de exportar el archivo a formato CSV. Esta parte es opcional y puedes utilizarla si deseas guardar una copia local del dataset o trabajar con él en otra herramienta externa como Excel o Power BI.
Adicionalmente, el código está estructurado para descargar correctamente el archivo directamente desde la URL proporcionada, utilizando una petición HTTP personalizada con encabezados (headers) que simulan un navegador real. Esto se hace para evitar bloqueos automáticos del servidor, ya que algunas plataformas protegen sus datos de accesos automáticos sin un encabezado válido.
Por último, el flujo de validación de la respuesta (status_code == 200) garantiza que solo se intente cargar el archivo si la descarga fue exitosa, evitando errores si por alguna razón el servidor no responde correctamente.
import pandas as pd
import requests
from io import StringIO

# URL del archivo CSV
url = "https://ourworldindata.org/grapher/median-age.csv"

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/115.0.0.0 Safari/537.36"
}

response = requests.get(url, headers=headers)

# Validar respuesta
if response.status_code == 200:
    csv_data = StringIO(response.text)
    df = pd.read_csv(csv_data)

    print(df.head())

    # Guardar el DataFrame en un archivo CSV (Opcional)
    #df.to_csv("median_age.csv", index=False)
else:
    print(f"Error al descargar: {response.status_code}")
En el siguiente paso, es importante crear una columna definitiva para almacenar la mediana de edad del conjunto de datos.
Inicialmente, el dataset proporciona dos valores:
Para este análisis, nos centraremos en los datos hasta el año 2025. Sin embargo, dado que a partir de 2023 los datos reales ya no están disponibles, es necesario implementar una estrategia que permita completar la columna definitiva:
# Primero, crear la columna "Median Age" tomando estimates
df["Median Age"] = df["Median age - Sex: all - Age: all - Variant: estimates"]

# Si hay NaN en "estimates", rellenar con "medium"
df["Median Age"] = df["Median Age"].fillna(df["Median age - Sex: all - Age: all - Variant: medium"])

# Ahora seleccionar solo las columnas deseadas
df = df[["Entity", "Code", "Year", "Median Age"]]

# Filtrar solo hasta el año 2025
df = df[df["Year"] <= 2025]

# Mostrar las primeras filas para validar
df.head(10)
A continuación, realizamos la visualización gráfica de la evolución de la edad mediana en Colombia y el mundo.
Primero, filtramos los datos para enfocarnos únicamente en dos entidades: Colombia y el promedio mundial. Esto nos permite comparar de manera directa su evolución histórica.
Posteriormente, creamos una figura de tamaño moderado para asegurar que la gráfica se vea bien tanto en dispositivos móviles como en escritorio.
Cada país es representado con un estilo de línea diferente:
Además de trazar las líneas, resaltamos dos puntos clave en la serie temporal:
Para mejorar la comprensión de estos hitos, se añaden anotaciones directas en el gráfico utilizando flechas y recuadros blancos semi-transparentes, haciendo que la información sea más clara sin saturar la visualización.
Finalmente, se agregan detalles importantes como:
Todo el diseño está pensado para que la gráfica sea limpia, elegante y comprensible a primera vista, tanto para publicaciones profesionales como para presentaciones educativas.
import matplotlib.pyplot as plt

# Filtrar Colombia y Mundo
df_filtered = df[df['Entity'].isin(['Colombia', 'World'])]

# Crear figura
fig, ax = plt.subplots(figsize=(8, 8))  # Ligero aumento de tamaño para redes

# Graficar Colombia
colombia = df_filtered[df_filtered['Entity'] == 'Colombia']
ax.plot(colombia['Year'], colombia['Median Age'], label='Colombia', color='#FF5733', linewidth=2.5, linestyle='-')

# Graficar Mundo
world = df_filtered[df_filtered['Entity'] == 'World']
ax.plot(world['Year'], world['Median Age'], label='Mundo', color='#3498DB', linewidth=2.5, linestyle='dotted')

# Marcar puntos clave
year_1980 = 1980
median_age_1980 = colombia[colombia['Year'] == year_1980]['Median Age'].values[0]
ax.scatter(year_1980, median_age_1980, color='#FF5733', s=70)

year_2025 = 2025
median_age_2025 = colombia[colombia['Year'] == year_2025]['Median Age'].values[0]
ax.scatter(year_2025, median_age_2025, color='#FF5733', s=70)

# Anotaciones con estilo más fino
ax.annotate(
    "En 1980, la edad media era de 18 años en Colombia;\nUna persona nacida en 1961 era mayor que la mayoría de personas.",
    xy=(1980, median_age_1980),
    xytext=(1955, 12),
    arrowprops=dict(arrowstyle='->', color='gray', lw=1),
    fontsize=10,
    bbox=dict(boxstyle="round,pad=0.4", fc="white", ec="none", alpha=0.7)
)

ax.annotate(
    "Si tienes 32 años o más actualmente,\nEres mayor que la mayoría de personas de Colombia y el Mundo.",
    xy=(2025, median_age_2025),
    xytext=(1972, 38),
    arrowprops=dict(arrowstyle='->', color='gray', lw=1),
    fontsize=10,
    bbox=dict(boxstyle="round,pad=0.4", fc="white", ec="none", alpha=0.7)
)

# Título principal
plt.title('¿Qué edad tienes comparado con el resto del mundo?',
          fontsize=15, fontweight='bold', loc='center', color='#333333')

# Ajustes de ejes
ax.set_xlabel('Año', fontsize=14, color='#333333')
ax.set_ylabel('Edad Mediana', fontsize=14, color='#333333')
ax.set_ylim(10, 43)
ax.set_xlim(1949, 2026)
ax.set_xticks(range(1950, 2026, 10))

# Fuente de datos
plt.text(1992, 8, 'Fuente: UN, World Population Prospects (2024)',
         fontsize=9, color='gray', ha='left')

# Mejorar diseño general
ax.grid(True, linestyle='--', alpha=0.3)
ax.legend(fontsize=12)
ax.set_facecolor('white')

# Ajustar espacio
plt.tight_layout(rect=[0, 0, 1, 0.94])

# Mostrar
plt.show()
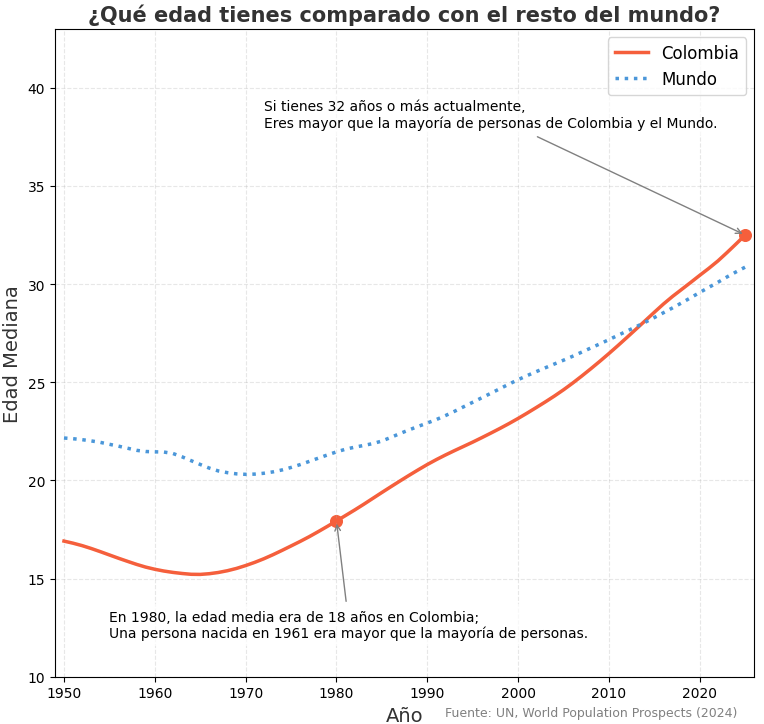
Al analizar la evolución de la edad mediana en Colombia y el mundo, podemos identificar varios hallazgos relevantes que reflejan cambios profundos en la dinámica poblacional:
Comparando el año 1980 con el año 2025, observamos un incremento notable en la edad mediana:
Este aumento refleja una transición demográfica en la que las poblaciones, tanto de Colombia como a nivel global, están envejeciendo rápidamente.
El incremento de la edad mediana es un claro indicador de que la población está envejeciendo. Esto se debe principalmente a dos factores:
El envejecimiento poblacional trae consigo varios desafíos y oportunidades:
Si en 2025 una persona tiene 32 años o más, será estadísticamente mayor que la mitad de la población colombiana y mundial. Esto resalta la magnitud del cambio demográfico y la importancia de adaptarse a un mundo donde la mayoría de la población ya no será joven.
Comprender estas tendencias no solo es vital para los gobiernos y las empresas, sino también para cada individuo que quiera anticipar los cambios sociales, laborales y económicos del futuro.
Desde un enfoque técnico, este ejercicio nos permitió recorrer todo el proceso de análisis exploratorio de datos: desde la carga de información desde una fuente confiable, su preparación y limpieza, hasta la visualización efectiva de tendencias clave a lo largo del tiempo.
Analíticamente, identificamos cómo la edad mediana ha cambiado de manera significativa, evidenciando un envejecimiento poblacional acelerado que impactará múltiples dimensiones de la vida social y económica en los próximos años.
Este tipo de ejercicios no solo fortalecen habilidades técnicas en Python y análisis de datos, sino que también desarrollan el pensamiento crítico necesario para interpretar correctamente las dinámicas del mundo real.
En Data World creemos firmemente que la curiosidad y la exploración de datos son pilares fundamentales para el crecimiento profesional en el mundo actual. Por eso, invitamos a todos nuestros lectores a ser curiosos, a cuestionar los datos, a buscar historias ocultas detrás de los números y a seguir practicando día a día.
En Data World amamos identificar insights valiosos a través de los datos. Contamos con un portafolio robusto de soluciones de datos de punta a punta (end-to-end), diseñado para ayudar a empresas y profesionales a transformar información en decisiones estratégicas. Nuestro equipo altamente capacitado está comprometido con llevar el poder de los datos a su máximo potencial.
¿Listo para descubrir el próximo gran insight? 🚀
Recibe en tu correo los mejores análisis, tendencias y recursos exclusivos de Data World.